MATE — 데이터 엔진 워크벤치
데이터셋 관리, 라벨링·검수, 학습 제출을 브라우저 도구 하나로 묶은 자체 호스팅 ML 데이터 워크벤치입니다. 실무에 쓰려고 직접 설계·개발했고, 폐쇄망 GPU 클러스터에 배포해 매일 쓰고 있습니다. 초점은 모델이 기존 라벨과 다르게 본 곳만 사람이 보는 데이터 엔진 루프입니다. 웹 수집과 다중 엔진 오토라벨 사이클을 붙여, 약 6만 장 규모 데이터에서 사람이 직접 본 장을 전체의 약 4%로 줄였습니다.
- 이름
- Manage · Annotate · Train · Evaluate — 마지막 E에 해당하는 평가 게이트는 다음 단계
- 기간
- 2026.08 ~ 진행 중 (2026.08.04 첫 커밋)
- 형태
- 자체 호스팅 웹 도구 — 파이썬 패키지 하나에 API 서버(FastAPI)와 React 프런트를 번들, 폐쇄망 GPU 클러스터에 배포
- 역할
- 1인 개발 — 설계, 서버·프런트 구현, 테스트·린트·CI 구성
- 기술
- Python · FastAPI · React · SQLite · Slurm · ultralytics · 오픈 VLM · ms-swift · SAM · CLIP
모델 코드 바깥에서 쓰는 시간
ML 실무의 상당 부분은 모델 코드가 아니라 그 주변에서 소모됩니다. 흩어진 주변 작업을 하나의 루프로 잇는 도구가 필요했습니다.
01 — 왜 만들었나
문제는 모델 코드 자체보다 그 주변이었습니다. 같은 종류의 작업이 반복되는데, 그 흔적은 매번 스크립트와 터미널, 노트북과 스프레드시트로 흩어졌습니다.
- 라벨링 · 검수 — 대상을 매번 스크립트로 잘라내고, 결과는 손으로 취합했습니다.
- 학습 — 어디에 어떤 설정으로 던졌는지가 터미널 히스토리에만 남았습니다.
- 평가 — 결과가 노트북과 스프레드시트에 흩어졌습니다.
이 과정을 브라우저 도구 하나로 묶기로 하고, 실무에 쓰려고 직접 설계·개발했습니다.
02 — 초점 — 데이터 엔진 루프
기능 목록은 길지만 초점은 한 문장입니다 — 모델이 기존 라벨과 다르게 본 곳만 사람이 본다. 전체를 처음부터 다시 훑는 대신, 아래 루프를 한 도구 안에서 닫는 것을 목표로 설계했습니다.
- 오토라벨 — YOLO 프리라벨, SAM 클릭·텍스트 분할, OpenAI 호환으로 서빙한 VLM의 검출·검증·태깅
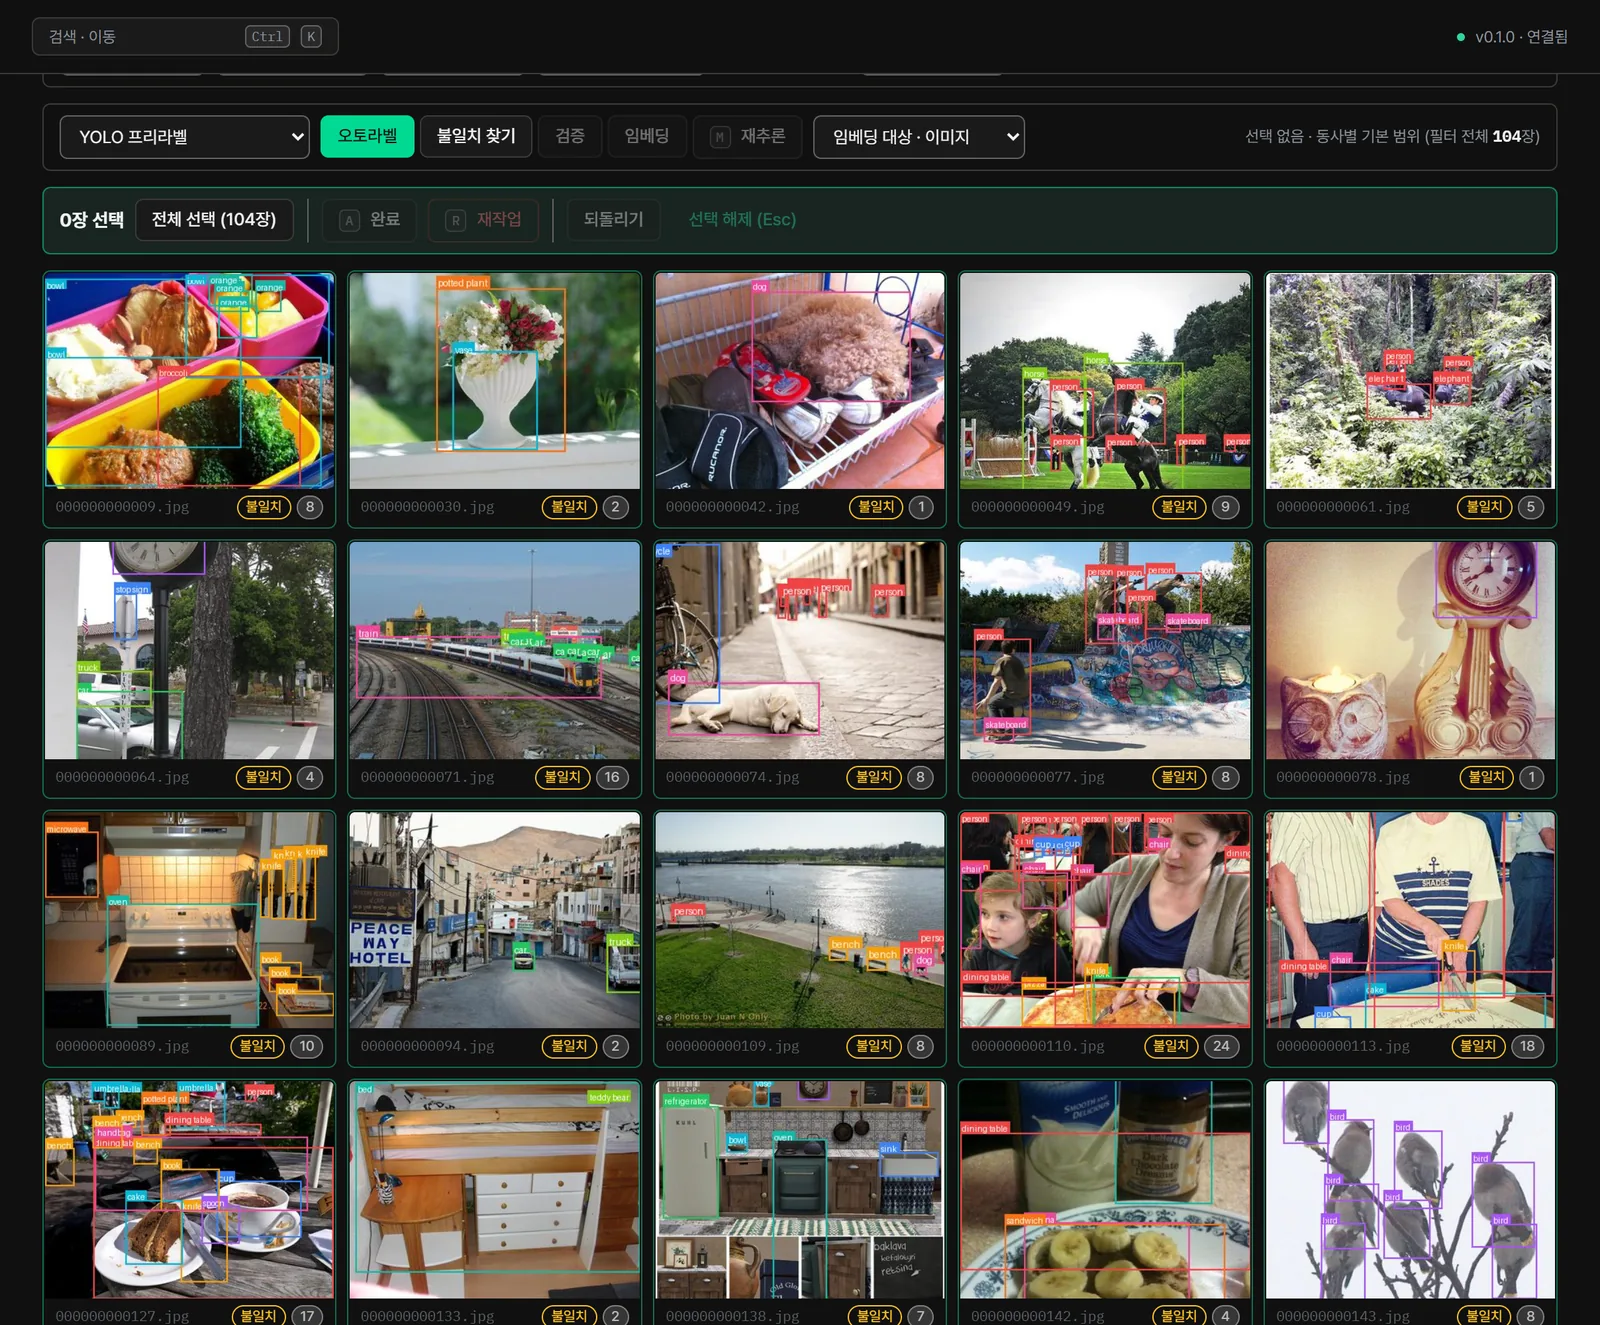
- 불일치 검사 — 기존 라벨과 모델 예측을 비교합니다. 검사는 판정만 기록하고 라벨은 바꾸지 않습니다.
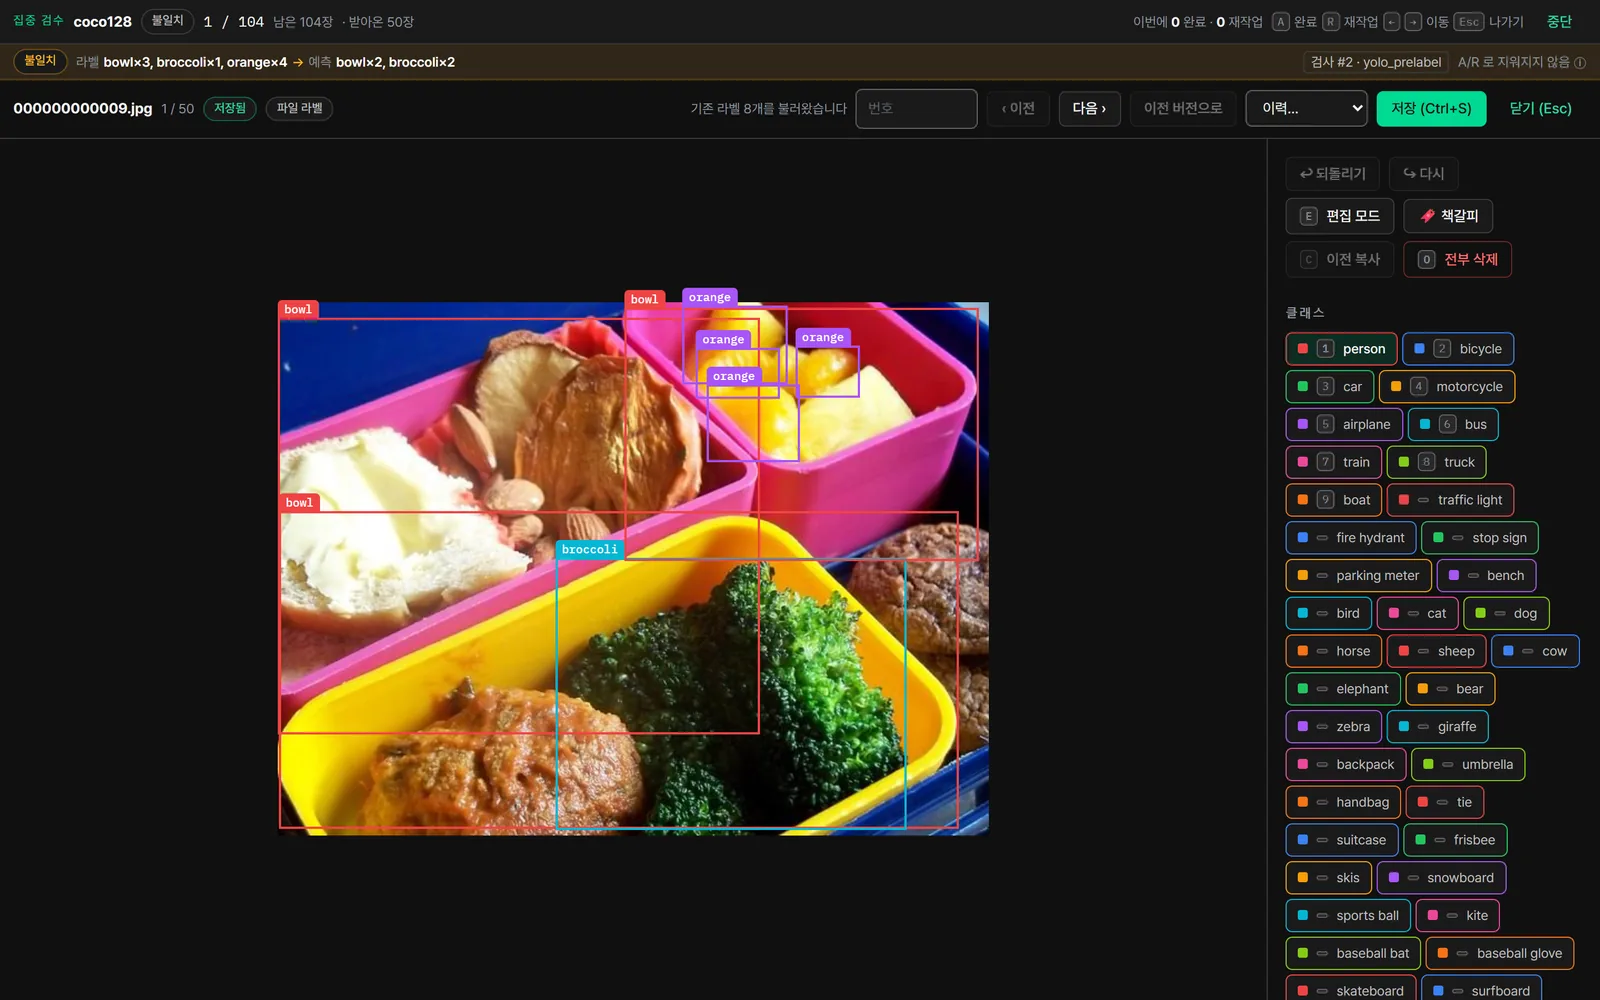
- 우선순위 검수 — 우선순위 점수를 매기고, 키보드 집중 검수 큐에서 승인·반려합니다.
- 데이터셋 버전 — 검수 결과를 분할과 매니페스트 sha256으로 고정한 불변 버전으로 만듭니다.
- 재학습 — Slurm으로 학습을 제출하고, 학습한 모델을 다시 보조 도구로 연결합니다.
실제로 수만 장 규모 객체 검출 데이터의 기존 라벨을 전수 검수할 때 이 루프를 썼습니다. 승인된 수백 장으로 VLM을 LoRA 튜닝하고 가벼운 크롭 분류기를 학습한 뒤, 라벨과 모델이 다르게 본 이미지만 사람이 검수했습니다.
설계 → 실사용 → 다음 단계
03 — 설계 결정 3가지
① 레포 하나 · 앱 하나, 경계는 플러그인 계약으로
파이썬 패키지 하나에 API 서버(FastAPI)와 React 프런트를 함께 번들했습니다. 기능 모듈(label · train 등)은 서로 직접 import하지 않고 core만 거칩니다. Trainer · Exporter · Synthesizer · Assist · Embedder는 레지스트리에 등록하는 플러그인으로 분리했습니다.
1인 개발로 기능이 빠르게 늘어나도 모듈 사이의 경계가 무너지지 않게 하려는 것입니다.
② 라벨은 append-only 스냅샷, 데이터셋 버전은 불변
라벨은 덮어쓰지 않고 append-only 스냅샷으로 쌓고, 데이터셋 버전은 분할과 매니페스트 sha256으로 고정한 불변 버전으로 만듭니다. 모델 검사는 판정만 기록할 뿐 라벨을 바꾸지 않습니다. 편집기는 base_version을 기준으로 저장해, 그 사이 라벨이 바뀌었으면 오래된 저장을 409로 거절합니다.
이미 완성된 데이터셋 위에서도 검사를 안전하게 반복할 수 있고, 학습 결과를 그 학습에 쓰인 정확한 데이터에 연결할 수 있습니다.
③ 폐쇄망 전제, 모든 작업은 Run으로 기록
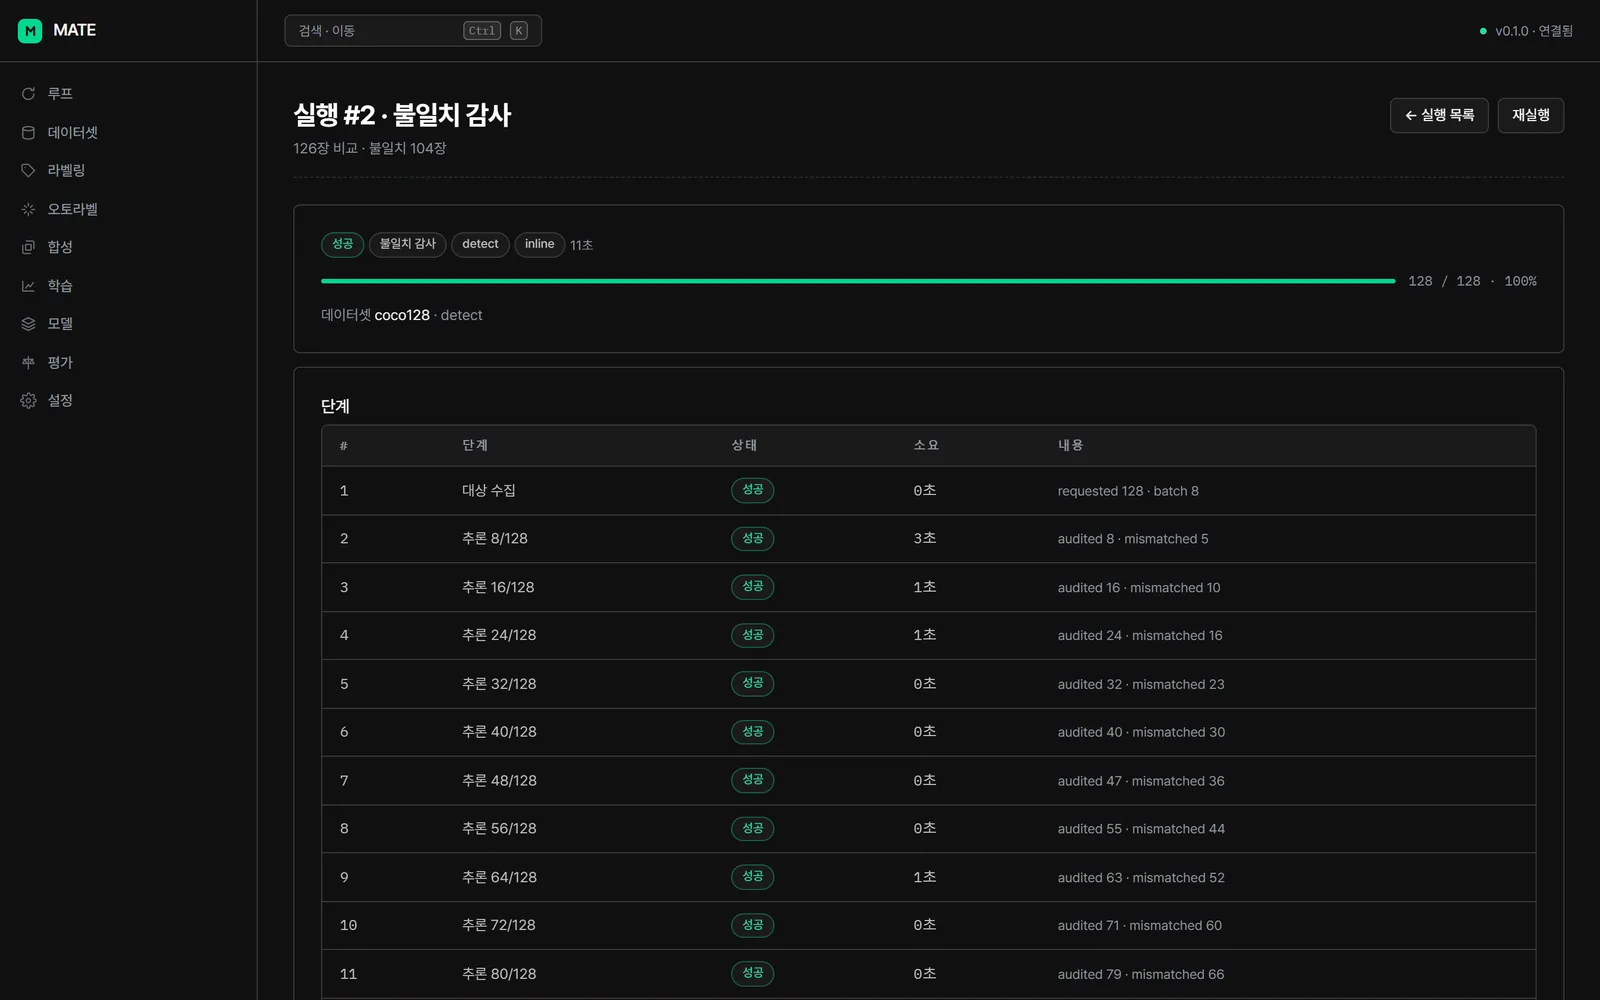
외부에서 아무것도 내려받지 않고, 호스트 · 경로 · 스케줄러 같은 환경 값은 설정 파일에만 둡니다. 오토라벨 · 검사 · 임베딩 · 버전 생성 · 학습(Slurm 제출) · 서빙은 모두 단계 · 진행률 · 취소 · 산출물을 가진 Run으로 남습니다.
인터넷이 없는 클러스터에서 재현성과 계보를 확보하기 위해서입니다. 학습 제출도 터미널 히스토리가 아니라 Run 기록으로 남습니다.
04 — 사람 손을 최소화하는 오토라벨 사이클 2026.09 ~ 10
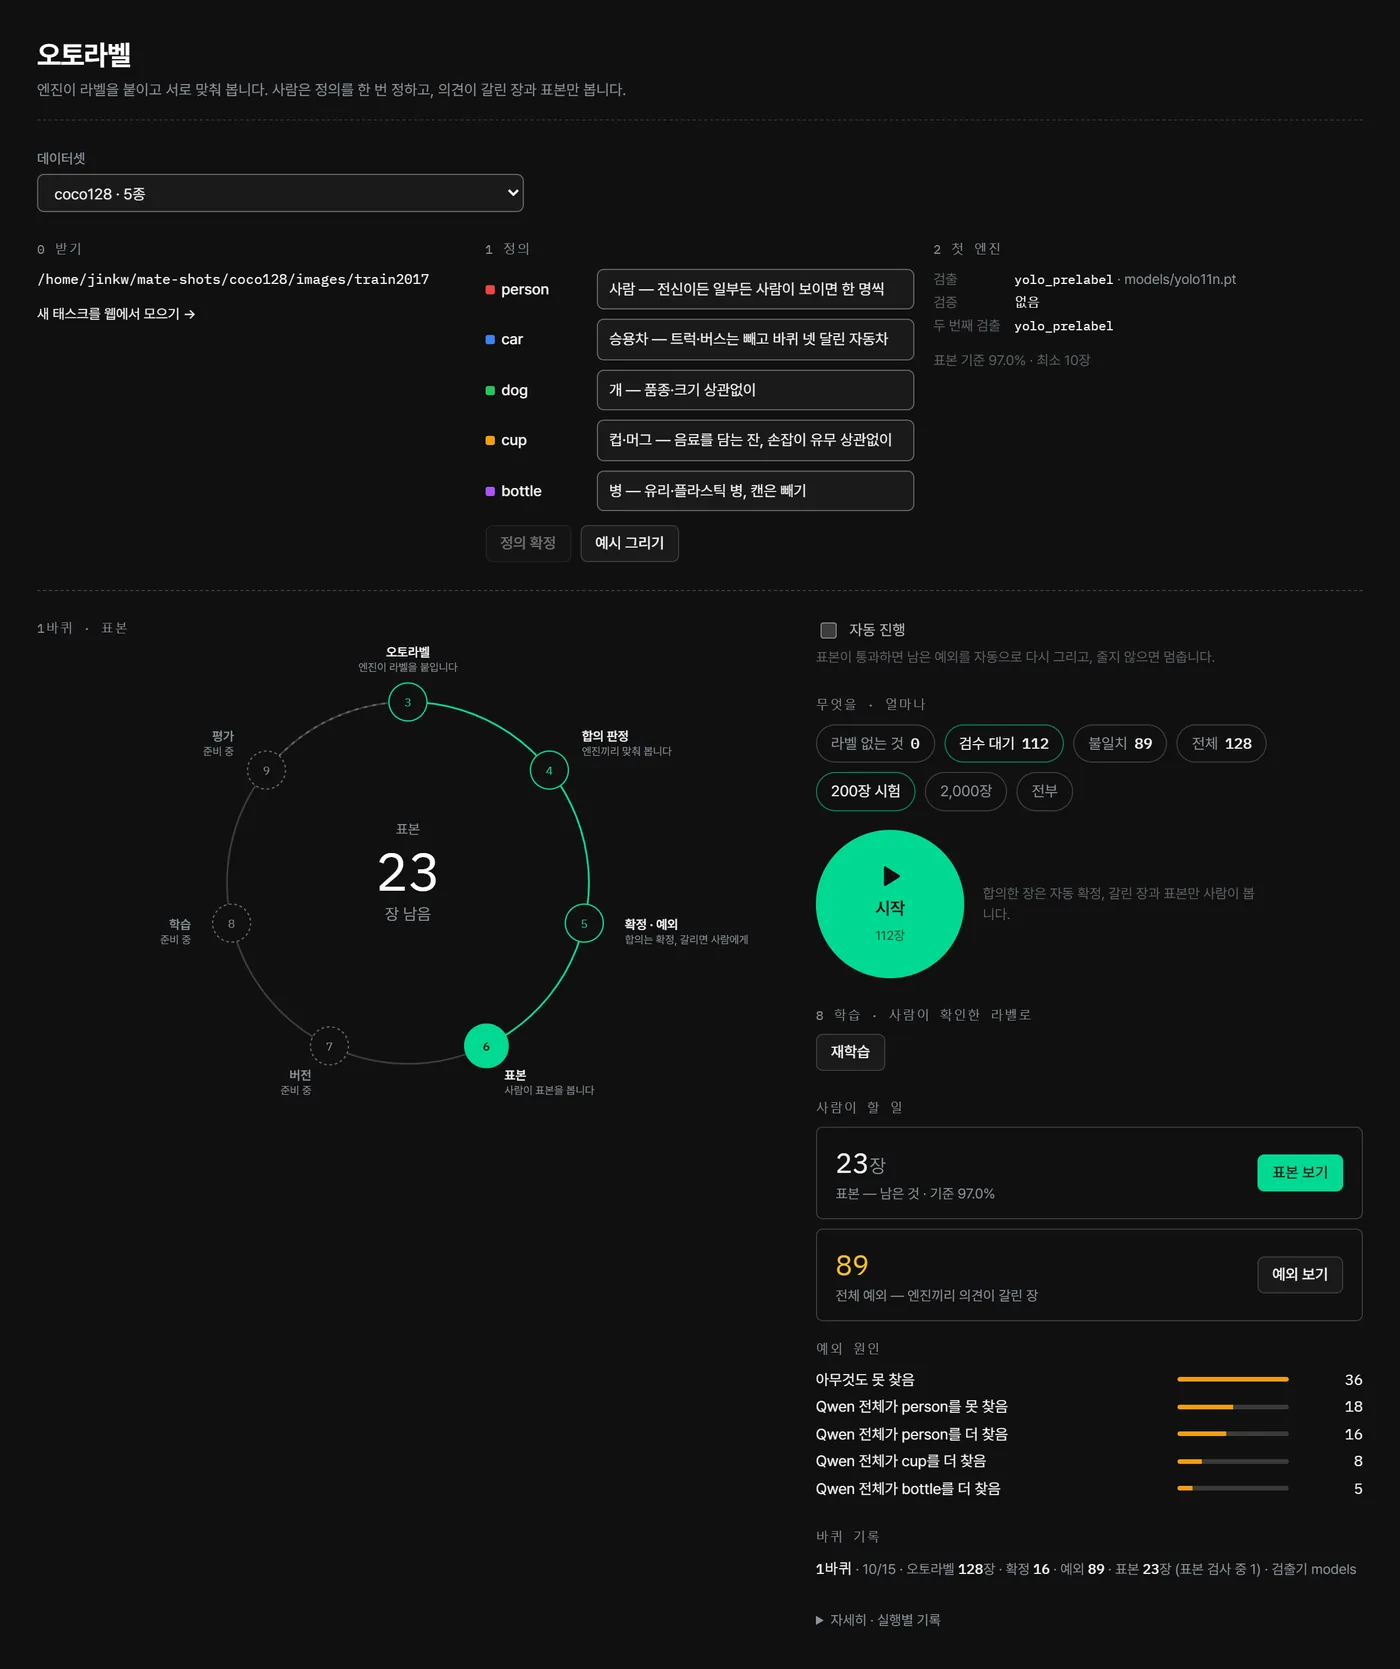
사람이 손대는 곳을 클래스 정의 · 예외 확인 · 표본 검수 세 군데로 줄이고, 나머지는 한 바퀴가 스스로 돌게 했습니다.
- 일괄 오토라벨 → 합의 판정 — YOLO 검출기가 박스를 그리고, 오픈 VLM(27B급)이 박스마다 클래스를 다시 판정하면서 그림 전체를 따로 검출합니다. 셋이 맞으면 합의이고, 기준을 겨우 넘은 매칭은 합의로 치지 않고 예외로 보냅니다.
- 자동 확정 · 예외 큐 — 합의한 장은 자동 승인(사람의 승인과 구별해 기록), 의견이 갈린 장은 불일치 검수 큐로 갑니다.
- 층화 · 계통 표본 검사 — 클래스 조합 · 크기 층마다, 촬영 순서대로 띄엄띄엄 표본을 뽑습니다. 표본 화면은 읽기 전용이라 맞으면 승인, 틀리면 반려만 누릅니다. 합격선(97%)에 못 미치면 그 바퀴의 자동 확정을 되돌리고, 약한 층만 되돌리기도 합니다.
- 다시 그리기 · 재학습 — 예외가 쌓이면 사람이 고치기 전에 새 검출기로 다시 그리거나, 사람이 승인한 장만으로 재학습해 다음 바퀴의 검출기로 겁니다. 엔진끼리 합의한 라벨로 엔진을 다시 가르치면 버릇이 굳어서 뺐습니다.
- 예외 원인 · 자동 진행 — 남은 예외를 원인별로 묶어 해 볼 것을 한 줄로 보여 줍니다. 자동 진행을 켜면 표본이 통과한 뒤 남은 예외를 스스로 다시 그리고, 표본 미달 · 예외 감소 10% 미만 · 남은 예외가 적을 때는 멈추고 이유를 남깁니다(아직 실전 투입 전).
실제 데이터 한 세트(약 6만 장 규모)의 바퀴별 결과
- 1바퀴 — 기존 라벨 전수 검사: 자동 확정 82% · 예외 16%
- 2바퀴 — 예외를 새 검출기 박스로 다시 그림: 예외 61% 감소, 표본 99% 통과
- 3바퀴 — 합의 규칙을 완화했더니 표본 정확도가 90%로 합격선에 못 미쳐, 그 바퀴의 자동 확정이 전부 자동으로 되돌아갔습니다(안전장치가 실제로 동작한 사례). 규칙을 다시 잡은 재시도는 표본 100% 통과
- 합계 — 예외 16% → 약 1%, 자동 확정 약 97%. 사람이 직접 본 장은 전체의 약 4%(표본 검수 + 루프를 만들기 전 첫 바퀴의 예외 수정)
- 처리량 — VLM 판정을 GPU 1장 · 동시 4건에서 GPU 8장 데이터 병렬 · 동시 32건으로 바꿔 약 7배
05 — 웹에서 모으기 — 첫 데이터와 오탐 사례 2026.10 · 1차 완성
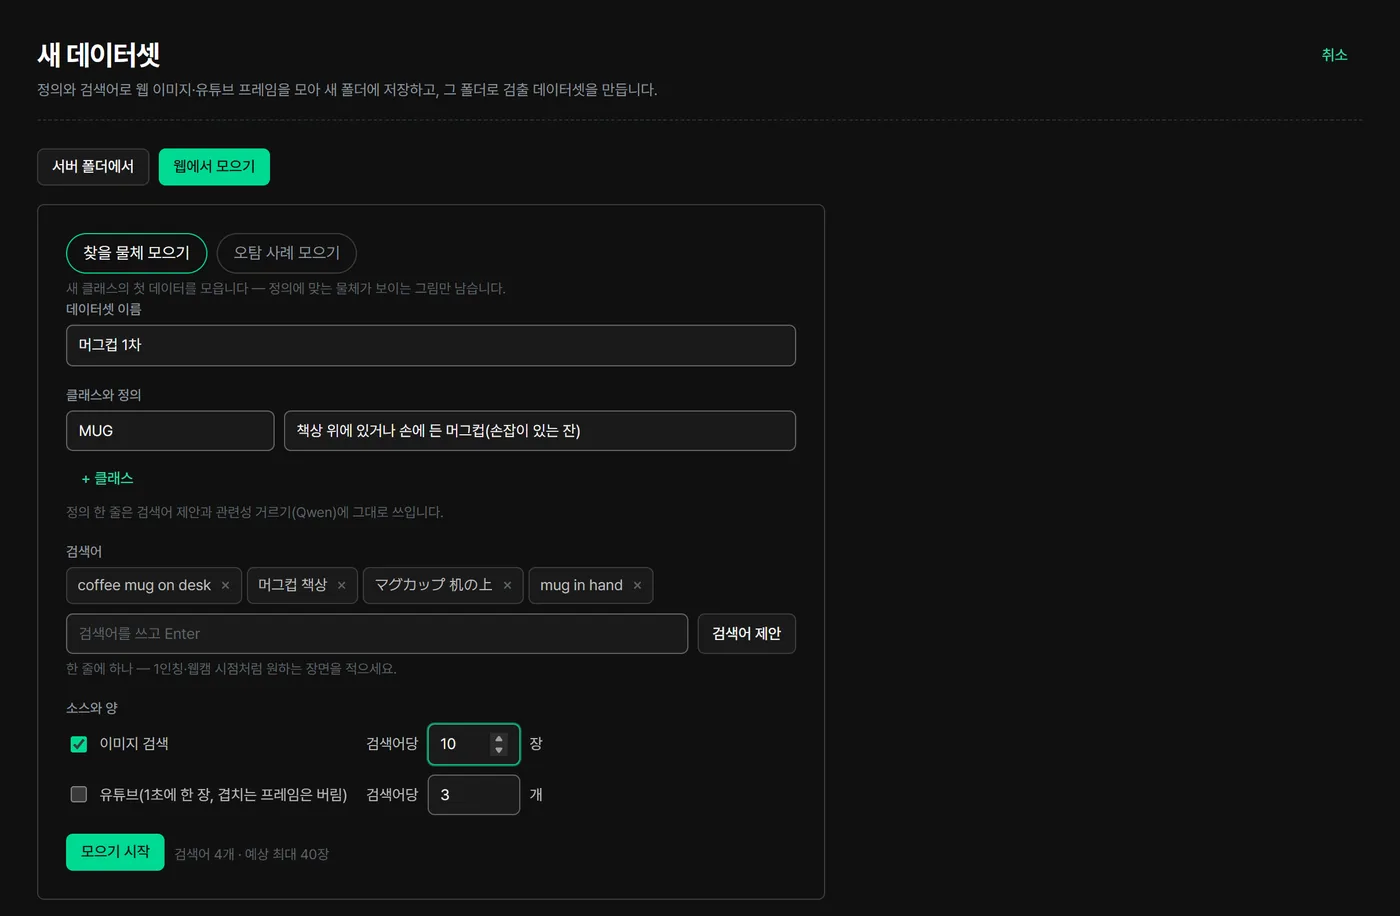
새 클래스는 오토라벨을 돌릴 그림부터 없어서, 수집도 같은 도구에 붙였습니다. 모은 그림은 정의를 가진 검출 데이터셋으로 열려 바로 오토라벨로 넘어갑니다.
- 검색어 제안 — 클래스 이름과 정의 한 줄을 주면 VLM이 한 · 영 · 일 동의어 · 기종 · 상황어로 검색어를 제안합니다(약 3초).
- 수집 · 거르기 — 이미지 검색과 유튜브 프레임(1초에 한 장, 앞 프레임과 같으면 버림)을 모아 sha1 · dHash로 중복을 거르고, VLM이 정의에 맞는 물체가 없는 그림을 옆 폴더로 뺍니다.
- 오탐 사례 모으기 — 장면 검색어로 모은 그림에 대상 검출기를 돌리고, 낸 박스마다 VLM에게 진짜인지 묻습니다. 전부 아니면 빈 라벨(하드 네거티브)로 데이터셋에 넣고, 오탐 박스는 따로 기록합니다.
검색어 하나로 이미지 10장(0.6초)과 영상 1편(프레임 137 → 중복 제거 32)을 모아 VLM 판정 후 36장을 남겼습니다. 오탐 사례 시험에서는 중복 제거 후 196장 중 대상 검출기가 낸 51장을 VLM이 모두 오탐으로 판정해 하드 네거티브로 넣기까지 93초가 걸렸습니다. 다만 대부분이 영상 한 편에서 나와 다양성은 더 봐야 하고, 재학습 효과는 아직 재지 않았습니다.
영상 · 검색어당 상한, 대량 수집을 Slurm 잡으로 분리, 하드 네거티브의 표본 검사 흐름.
06 — 실사용에서 고친 것
객체 검출 데이터 검수 외에 소규모 키포인트 · 영상 프레임 데이터 라벨링에도 쓰고 있습니다. 실사용에서 드러난 문제와 고친 방법입니다.
이미지를 전환하는 도중 이전 이미지의 저장 응답이 늦게 도착하면, 그 응답이 다음 이미지의 라벨을 덮어쓰는 오염이 생겼습니다.
편집 상태를 문서(이미지) 단위로 관리하도록 바꾸고, 서버 쪽에 버전 가드를 두어 기준 버전이 맞지 않는 저장을 받지 않게 했습니다.
늦게 도착한 저장 응답이 다른 이미지의 라벨을 덮어쓰는 경로를 차단했습니다.
07 — 지금 되는 것 / 다음 단계 2026.10.15 기준
지금 되는 것
- 데이터셋 — YOLO txt 형식 등록, 필터 갤러리, 웹에서 모으기(찾을 물체 · 오탐 사례)
- 편집 · 검수 — 박스 · 폴리곤 편집기, 분류 태깅, 승인 · 반려, 키보드 집중 검수 큐, 라벨 이력 복원
- 보조 도구 — YOLO 프리라벨, SAM 클릭 · 텍스트 분할, OpenAI 호환 서빙 VLM으로 검출 · 검증 · 태깅, 크롭 분류기 검증
- 검사 — 라벨 vs 예측 불일치 검사, 우선순위 점수, CLIP 임베딩 기반 유사 이미지
- 오토라벨 사이클 — 다중 엔진 합의, 자동 확정 · 예외 큐, 층화 표본 검사와 되돌리기, 사람 승인분만 버전 → 재학습 → 검출기 교체, 예외 원인 요약과 자동 진행
- 내보내기 —
yolo·yolo_seg·imagefolder(크롭) ·sharegpt(VLM) ·masks - 학습 — Slurm 제출(ultralytics detect · segment · classify, ms-swift VLM LoRA), 프리셋, 제출 전 검사, 모델 레지스트리, 학습한 모델을 보조 도구로 연결
- 합성 —
augment·copy_paste·crop_derive - 화면 — 데이터셋별 루프 다이어그램, Run 단계 기록
다음 단계 — 아직 구현하지 않은 부분입니다.
- 평가 게이트 — 챔피언 / 챌린저 모델을 홀드아웃에서 비교하는 단계. 이름의 마지막 E(Evaluate)에 해당하며 다음 단계로 남아 있습니다.
- 보류 — timm 학습기
- 미지원 — COCO 형식 가져오기 · 내보내기
화면
공개 데이터 COCO 128장(Ultralytics coco128)과 Ultralytics 공개 가중치(YOLOE · YOLO11n)로 실제 MATE 화면을 촬영했습니다. 회사 데이터는 들어 있지 않습니다.